実践・検証
AIのCSV集計はどこまで信じられる? 13行の売上データで再計算した検証
欠損、保留、下書きを含む13行の架空CSVをGPT-5.6 Solで集計し、採用行、地域別合計、前月比を別計算で照合した実務検証の条件と結果を公開します。
- 公開日
- 最終検証
- 次回確認
- 確信度
- HIGH
検証したこと
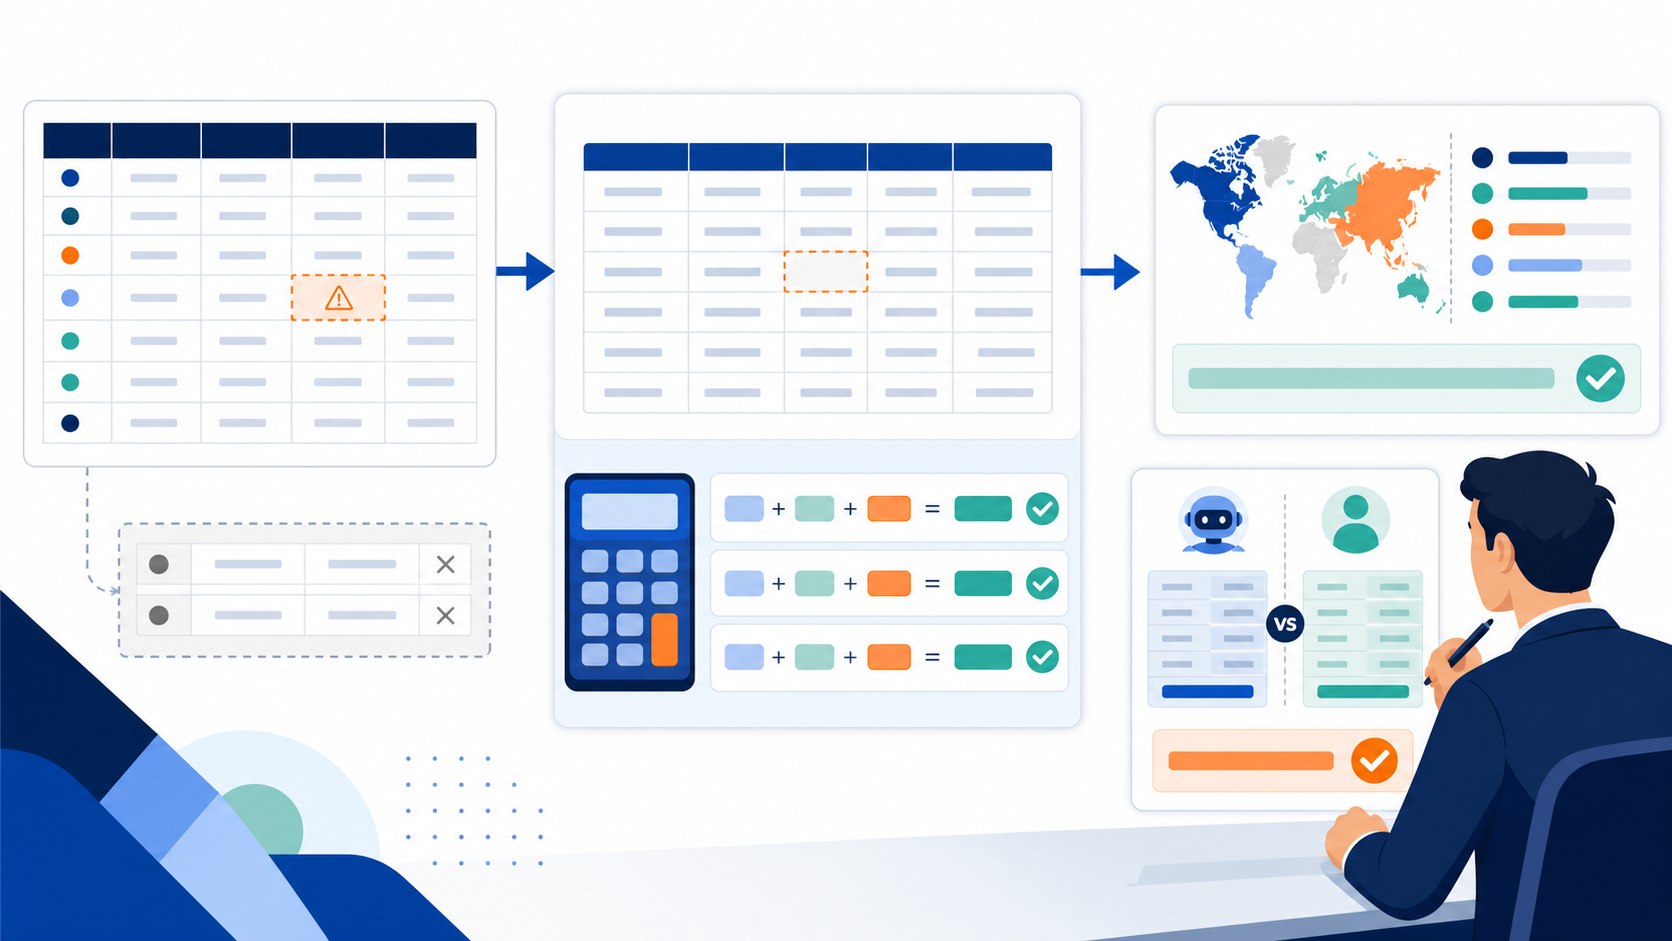
AIへCSVを渡すと、短時間で合計や傾向を返してくれます。問題は、見栄えのよい表が出たことと、正しい条件で計算されたことが同じではない点です。
そこで、欠損値、保留行、下書き行を混ぜた13行の架空売上CSVを用意し、次を検証しました。
- 集計対象11行だけを選べるか
- 地域別合計と総合計を正しく計算できるか
- 欠損月を0円として扱わないか
- 隣接する2か月が揃う地域だけで前月比を計算できるか
- 除外理由と計算方法を結果へ残せるか
 入力条件、構造化結果、別計算を分けると、AIの回答を「再現できる集計」へ変えられる。
結論: 今回の条件では正しい集計を返しました。ただし、成功の理由はモデル名だけではなく、採用条件、欠損の扱い、出力形式、再計算式を先に固定したことにあります。
検証環境
| 項目 | 条件 |
|---|---|
| 実行日 | 2026年8月11日 |
| CLI | Codex CLI 0.144.1 |
| モデル | GPT-5.6 Sol |
| 推論 | high |
| サンドボックス | read-only |
| 検索 | 使用しない |
| 入力 | 架空のCSV 13行 |
| 出力 | 固定JSON Schema |
顧客情報、社内売上、個人情報は使っていません。モデルへはCSVと計算規則だけを渡し、ファイル変更や外部検索は許可していません。
入力データに入れた落とし穴
地域はEast、West、Central、Northの4つ、期間は2026年1〜3月です。通常行に加えて、次の2行を除外対象にしました。
record_id,month,region,sales_yen,status,include_in_total
R005,2026-02,West,,pending,FALSE
R013,2026-03,East,99999,draft,FALSER005は売上値が空で保留、R013は金額がありますが下書きです。「空欄を0円にしない」「confirmedかつinclude_in_total=TRUEだけを採用する」と明示しました。
さらに、前月比は同じ地域で隣接月が両方採用されている場合だけ計算する条件にしました。Westは2月が欠損・保留なので、1月から3月を連続した前月比として扱ってはいけません。
実行結果
AIが返した主要値は次のとおりです。
| 指標 | 結果 | 別計算 |
|---|---|---|
| 全行数 | 13 | 13 |
| 採用行数 | 11 | 11 |
| East | 3,450,000円 | 3,450,000円 |
| West | 2,250,000円 | 2,250,000円 |
| Central | 2,460,000円 | 2,460,000円 |
| North | 1,800,000円 | 1,800,000円 |
| 総合計 | 9,960,000円 | 9,960,000円 |
| 最大の前月比減少 | East、2月→3月 | East、2月→3月 |
| 減少額・率 | 450,000円、33.3% | 450,000円、33.3% |
除外行としてR005とR013が列挙され、Westの2月欠損は0円扱いせず、同地域の前月比を計算できないという警告も返りました。
計算は次の式で独立に確認しました。
East = 1,200,000 + 1,350,000 + 900,000 = 3,450,000
総合計 = 3,450,000 + 2,250,000 + 2,460,000 + 1,800,000 = 9,960,000
East減少率 = (1,350,000 - 900,000) / 1,350,000 × 100 = 33.3%
うまくいった理由
採用条件を自然文だけで終わらせなかった
status=confirmedとinclude_in_total=TRUEの両方を条件にしました。単に「確定データだけ」と書くより、列名と許容値を指定した方が再現しやすくなります。
欠損と0を分けた
空欄を0円と解釈すると、Westの2月は100%減、3月は無限大に近い増加として誤った説明が生まれます。欠損は「分からない」であり、売上0円ではありません。
JSON Schemaで出力項目を固定した
行数、除外ID、地域別合計、総合計、最大減少、警告、計算メモを必須にしました。文章だけの回答より、欠けた項目を機械的に発見できます。
再現用の依頼文
今回の依頼は、分析の目的より計算規則を先に書きました。実データへ流用するときは、列名と許容値を自社定義へ置き換えます。
CSVだけを分析する。
全行数を数える。
status=confirmed かつ include_in_total=TRUE の行だけを集計する。
空のsales_yenは0ではなく欠損とする。
地域別合計と総合計を整数の円で返す。
前月比は、同じ地域で隣接する2か月が両方採用された場合だけ計算する。
除外したrecord_id、欠損、計算式を警告とメモへ残す。
原因は推測しない。
実務では、ここへ「返品控除後か」「税込か」「締め後の訂正を含むか」などの業務定義を追加します。AIが列名から意味を推測できても、その推測を正式な計算規則にはしません。
この検証で分からないこと
- 何万行・何百万行でも同じ精度になるか
- Excelの数式、結合セル、複数シートを正しく解釈できるか
- 業務固有の「売上」「返品」「確定」の定義を自動で理解できるか
- 別モデルや別設定でも同じ結果になるか
- 数値が正しくても、原因の説明まで正しいか
今回の成功を、すべての表データ分析に一般化してはいけません。実データでは、件数、型、重複、単位、分母、除外条件を先に検査します。
実務で使う再現手順
- 元ファイルを変更せず、分析用コピーを作る
- 1行1レコード、1列1項目へ整える
- 採用条件と欠損の意味を列値で定義する
- AIへ対象件数、除外件数、計算式、警告を出させる
- 合計、件数、比率を表計算ソフトやSQLで再計算する
- 不一致なら説明を直す前に、対象行と条件を確認する
- 機密データのアップロード可否を組織のルールで確認する
より一般的な前処理はAIへ社内データを入力する前のチェックリスト、出力確認はAIの回答を鵜呑みにしない検証チェックリストも参照してください。
AI活用ナビの判断
AIによるデータ分析の価値は、グラフを速く作ることより、問いを狭め、除外条件を見える形にし、人が再計算できる材料を揃えることにあります。結果だけを貼り付けず、「何行を使い、何行を除外し、どの式で計算したか」を成果物の一部にしてください。
PRIMARY SOURCES
確認した一次情報
広告