AIニュース
OpenAIが「保存しない安全監視」を予告 ZDR導入で確認すべき5つの境界
OpenAIが発表したPrivate Safety ProcessingとZero Data Retentionの関係を一次情報から整理します。「学習に使わない」と「保存しない」の違い、対象外機能、第三者サービス、自社ログなど、企業が導入前に確認すべき境界を解説します。
- 公開日
- 最終検証
- 次回確認
- 確信度
- MEDIUM
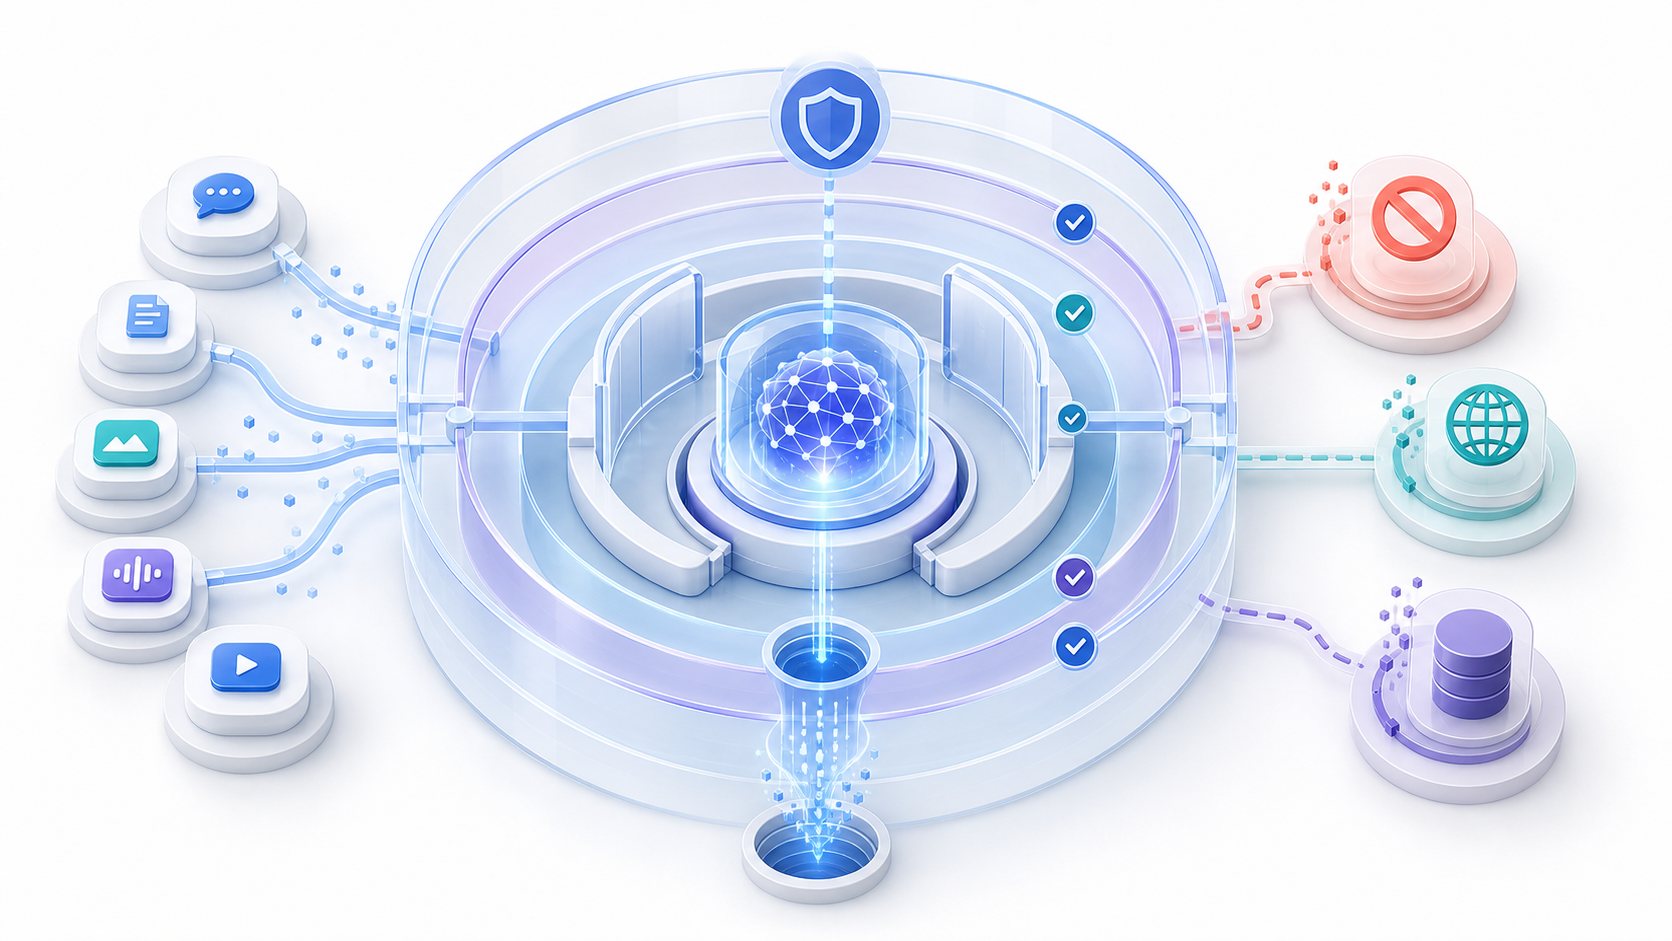
OpenAIは2026年8月19日、フロンティアモデルでもZero Data Retention(ZDR)を維持するための新しい仕組み「Private Safety Processing」を発表しました。
この発表から企業のAI担当者が押さえるべき結論は、単に「OpenAIがデータを保存しなくなった」ということではありません。重要なのは、長時間動く高性能なAIを監視するために、会話や操作の文脈をどこかへ残したい安全上の要請と、機密情報をAI提供者に残したくない企業側の要請を両立させようとしている点です。
一方、ZDRを有効にしても、システム全体のデータが自動的に消えるわけではありません。利用できるAPI機能、アプリケーション状態、自社側のログ、接続先のMCPサーバー、法令・安全上の例外を個別に確認する必要があります。
この記事では、OpenAIの発表とAPIドキュメントで確認できた事実を基に、次の点を整理します。
- 今回の発表で新しく示されたものは何か
- 「学習に使わない」と「保存しない」はどう違うか
- ZDRでも残り得るデータや対象外機能は何か
- Private Safety Processingを企業がどう評価すべきか
- 機密データを扱うAIシステムの導入前チェック手順
なお、Private Safety Processingは発表時点で先行顧客とテスト中のプレビューです。本記事は公開された仕様の確認と実務上の分析であり、実環境における保存状況や暗号処理を独立に検証した結果ではありません。
なぜ今、データ保持と安全監視が衝突するのか
従来のチャット型AIでは、利用者が質問を送り、AIが回答を返す一往復の処理が中心でした。この形であれば、不正利用の兆候をリクエストごとに判定する設計も比較的理解しやすいでしょう。
しかし、AIエージェントが複数の資料を読み、外部ツールを操作し、数十分から数時間にわたって作業するようになると、一回の入出力だけでは判断できない問題が増えます。
例えば、個々には無害に見える依頼でも、連続して見ると次のような意図が浮かぶことがあります。
- 制限を回避する方法を少しずつ質問している
- 複数アカウントから同じ対象を調べている
- 正規の調査に見せかけて攻撃手順を組み立てている
- 利用者が停止を指示した後もエージェントが操作を続けている
- 最初に与えた権限や目的から徐々に逸脱している
OpenAIは2026年8月19日の発表で、既存のZDR対応安全システムは各インタラクションを個別に評価する一方、深刻なリスクは複数のやり取りを関連付けて初めて見える場合があると説明しています。
ところが、複数のやり取りを監視するには、何らかの形で過去の状態を参照する必要があります。ここで「安全のために文脈を保持したい」という提供者側の要求と、「契約書、医療情報、研究データ、未公開コードを提供者側に保持させられない」という顧客側の要求が衝突します。
Private Safety Processingは、この衝突を暗号技術と権限分離によって解こうとする構想です。今回のニュースの核心は、新しいモデル名や性能向上ではなく、安全監視のためのデータ管理構造そのものが製品要件になったことにあります。
まず区別したい5種類の「データ利用」
AIサービスの説明で混乱しやすいのは、「学習しない」「保存しない」「人が見ない」といった表現が、同じ意味のように扱われることです。実際には別々の管理項目です。
| 確認項目 | 意味 | ZDRだけで判断できるか |
|---|---|---|
| モデル学習 | 入力や出力をモデル改善用の訓練データに使うか | できない。学習方針を別に確認する |
| 不正利用監視ログ | ポリシー違反や攻撃を調べるためにプロンプト、出力、判定結果を保持するか | ZDRの主な対象だが例外条件がある |
| アプリケーション状態 | 会話、ファイル、スレッド、バッチ処理など、機能提供に必要なデータを保持するか | エンドポイントごとの確認が必要 |
| システムデータ | アカウント、請求、利用量、障害記録などのメタデータを保持するか | 「顧客コンテンツを残さない」とは別問題 |
| 第三者への送信 | MCPサーバー、検索先、社内データベースなどへ情報が渡るか | 接続先ごとの規約と保存設定が必要 |
OpenAIのモデル改善に関する方針では、APIやビジネス向け製品の入力・出力は、顧客が明示的にオプトインしない限り、モデル学習に使用しないとされています。
これはZDRとは別の約束です。「学習しない」設定でも、不正利用監視や機能提供のために一定期間保存される可能性があります。反対に、ZDRを利用していても、自社が明示的に別のデータ共有へ同意したり、第三者サービスへ送信したりすれば、その経路について別の確認が必要です。
したがって、社内の承認資料に「学習されないので保存もされない」と書くのは不正確です。最低でも、学習、不正利用監視、アプリケーション状態、第三者送信を分けて記載する必要があります。
OpenAIが発表したPrivate Safety Processingの仕組み
発表で示された構成は、大きく二つです。
一つ目は、顧客コンテンツを顧客が管理するインフラに置くZDR構成です。二つ目は、OpenAIのインフラへ保存する場合でも、顧客が管理する鍵で暗号化し、OpenAIの担当者が鍵を保持しない構成です。
OpenAIの説明による処理の流れは、次のように整理できます。
- 関連する複数のやり取りを自動システムが評価する。
- 元のプロンプトや回答をOpenAIの担当者へ開示せず、危険なパターンを検出する。
- リスクを検出した場合、活動の種類を示す限定的な安全シグナルをOpenAIへ返す。
- OpenAIはシグナルを基に、必要なら利用制限などを判断する。
- 顧客は自社側にある情報を使って通知や判断を調査し、異議申立てなどに必要な情報を任意で共有する。
ここで注意したいのは、「OpenAIの担当者が元データを読めない」という説明と、「処理に顧客コンテンツを利用しない」という説明は異なることです。Private Safety Processingは、保存場所にかかわらず顧客コンテンツを自動処理し、関連するやり取りのパターンを見つける設計だとされています。
つまり、目指しているのは監視をなくすことではありません。人が元データへアクセスせず、顧客がデータや暗号鍵の支配を維持したまま、機械的な安全監視を成立させることです。
この設計が公表どおり機能すれば、情報を保持させられない企業でも高性能モデルを選択しやすくなる可能性があります。ただし、発表時点では技術白書、脅威モデル、鍵管理の詳細、誤検知時の運用、利用可能なモデルと地域の完全な一覧は公開されていません。現段階で「暗号化されているから安全」と導入を即決するのは早計です。
ZDRは「システムのどこにも何も残らない」という意味ではない
OpenAIのAPIデータ管理ドキュメントによれば、標準設定では不正利用監視ログにプロンプトや回答などの顧客コンテンツが含まれる場合があり、原則として最長30日保持されます。より長い保持が法的に必要な場合や、サービスまたは第三者を危害から守るため合理的に必要な場合は例外があります。
ZDRは対象顧客が自動的に利用できる一般設定ではありません。OpenAIによる事前承認と追加要件への同意が必要とされ、組織単位またはプロジェクト単位で設定します。
承認後も、すべてのAPI機能が同じ挙動になるわけではありません。2026年8月22日に確認したドキュメントでは、次のような差が示されています。
/v1/responsesと/v1/chat/completionsでは、ZDR有効時にstoreをtrueで送ってもfalseとして扱われる。- Conversations、Assistants、Threads、Vector Stores、Files、Fine-tuning、Evals、Batchesなどには、ZDR非対応または別のapplication state保持条件がある。
- 音声出力には、複数ターンの会話を成立させるための一時的な状態保持がある。
- Prompt Cachingでは、暗号化されたキー・バリューテンソルがGPUローカルストレージへ一時保存される場合がある。
- Hosted ShellやCode Interpreterなどのコンテナは、稼働中に一時的なファイル状態を持つ場合がある。
- 外部のMCPサーバーやネットワーク接続先へ送ったデータは、接続先の保持方針に従う。
- 画像やファイルは児童性的虐待コンテンツの検出対象となり、分類器が該当可能性を検出した場合は、ZDRが有効でも人による確認のため保持される場合がある。
- 動画APIなど、データ保持制御を有効にしたプロジェクトでは利用できない機能がある。
さらに、公開ドキュメントには「Eyes Off」と「Safety Retention」という例外的な取扱いも記載されています。特定の顧客についてモデルをZDR非対応に変更する場合や、重大なリスク活動の調査・防止が合理的に必要な場合に、事前の書面通知を前提として保持条件が変わる可能性があります。Safety Retentionでは、分類器がポリシー違反の可能性を検出したコンテンツが保持され、人による確認対象となる場合があるとされています。
このため、ZDRを社内規程へ記載するときは、「一切の例外なく、いかなるデータも保存されない」と要約してはいけません。適用対象、機能別制限、通知条件、安全上・法令上の例外まで契約と最新ドキュメントで確認する必要があります。
企業利用への影響は、設定ではなくアーキテクチャに現れる
今回の発表により、ZDRは調達部門がチェックする契約項目だけでなく、システム設計を左右する条件になります。
例えば、契約書レビュー支援システムを考えます。利用者が契約書をアップロードし、AIがリスク条項を抽出し、社内の過去契約を検索し、結果を会話履歴へ残す構成です。
このシステムにZDRを適用したい場合、「OpenAIとの契約がZDRだから完了」とはなりません。少なくとも次の経路を分ける必要があります。
- 利用者のブラウザや端末に残る一時ファイル
- 自社Webアプリのアクセスログとエラーログ
- APIゲートウェイに記録されるリクエスト本文
- OpenAI APIへ送るプロンプトと添付ファイル
- 会話履歴を保存する自社データベース
- 過去契約を検索するベクトルストア
- MCPサーバーや外部検索サービスへ渡すデータ
- 監視ツールへ送信されるトレース、例外、スクリーンショット
- 担当者が結果をコピーするチケット、メール、チャット
OpenAI側で顧客コンテンツを保持しなくても、自社のAPIゲートウェイがリクエスト本文を90日保存していれば、「システム全体として保存しない」とは言えません。また、外部MCPサーバーへ契約書本文を送れば、その提供者の保持方針が新たな境界になります。
逆に、何も記録しない設計も安全とは限りません。誤った送信、権限逸脱、不正利用、費用急増が起きたとき、原因を調べる証拠がなくなるからです。必要なのはログをゼロにすることではなく、本文を複製せずに調査できる監査情報を残すことです。
例えば、次の情報は内容そのものを保存しなくても記録できます。
- 実行日時と利用者ID
- 使用したプロジェクト、モデル、エンドポイント
- 入力データの機密区分
- 呼び出したツール名と成否
- 承認者と承認時刻
- 入出力の件数やサイズ
- ポリシー判定の種類
- コンテンツを復元できない形式の照合値
- 保存期間と削除処理の結果
この設計なら、機密本文の複製を抑えながら、誰がどの権限で何を実行したかを追跡しやすくなります。
導入前に実行する8段階の確認手順
1. ZDRを必要とする理由を具体化する
「セキュリティが心配だから」だけでは設計条件を決められません。対象データ、守るべき契約、想定事故を明文化します。
例として、顧客の個人データ、未公開の設計図、ソースコード、法務文書、研究情報などを区分し、何が何時間・何日残ると問題になるのかを整理します。
個人情報については、保存期間だけでなく、AIへ入力すること自体が利用目的の範囲内か、提供者による取扱いが想定と一致するかも確認が必要です。個人情報保護委員会の生成AIに関する注意喚起も、利用目的や提供者側の取扱いを確認するよう求めています。
2. データフローを一枚に描く
利用者の入力から最終出力まで、データが通る場所を列挙します。OpenAIだけでなく、クラウド、監視、検索、MCP、社内ストレージ、バックアップ、利用者端末を含めます。
各経路について、処理だけか、メモリに載るか、ディスクへ書くか、ログへ複製するか、別会社へ送るかを記録します。「保存なし」という言葉をシステム全体の性質として使うのではなく、経路ごとの状態として扱うのがポイントです。
3. 適格性と契約条件を確認する
ZDRは公開画面で誰でも有効にできる機能ではなく、対象顧客の承認が必要です。営業担当や契約窓口に、対象となる組織ID、プロジェクト、モデル、地域、エンドポイント、開始日、例外通知の方法を確認します。
口頭説明だけでなく、契約、注文書、データ処理条項、管理画面の設定を照合してください。「ZDR対応可能」と「自社プロジェクトで有効になっている」は別の状態です。
4. エンドポイント単位で保持表を作る
利用予定のAPIについて、次の列を持つ表を作ります。
- APIまたはツール名
- ZDR適格性
- 不正利用監視ログの保持
- application stateの保持
- 一時ファイルやキャッシュ
- 削除方法
- 第三者送信
- 安全上・法令上の例外
機能追加やモデル変更のたびに表を更新します。NISTの生成AIリスク管理プロファイルも、個人識別情報などの漏えいリスクを踏まえてデータの収集・保持方針を定め、既存のIT・法務・リスク管理と結び付けることを推奨しています。
5. 自社ログから本文を外す
開発環境ではデバッグのため、HTTPリクエストや例外を丸ごと記録しがちです。本番投入前に、プロンプト、回答、添付ファイル、認証情報がログへ入らないことを確認します。
特にAPIゲートウェイ、APM、エラー追跡、セッション再生、サポートツールを点検します。必要な監査証跡は、利用者、操作種別、承認結果などの構造化メタデータへ置き換えます。
6. 外部ツールを別事業者として審査する
MCPサーバーや検索サービスをOpenAIの一機能のように見なしてはいけません。APIドキュメントも、外部MCPサーバーへ送ったデータは第三者の保持方針に従うと明記しています。
接続先ごとに、送信項目、保存期間、学習利用、再委託先、データ所在地、削除方法を確認します。確認できないサービスには、個人情報や機密情報を送らない設計を選びます。
7. 失敗条件を含む受け入れテストを行う
正常な回答が返ることだけでは不十分です。ZDR対象外の機能を呼んだ場合、store=trueを指定した場合、外部ツールが失敗した場合、管理設定を変更した場合にどうなるかを確認します。
少なくとも、次の結果を証拠として残します。
- 対象プロジェクトでZDRが有効であること
- 利用予定機能が許可または拒否される挙動
- 自社ログへ本文が出力されないこと
- 一時ファイルが期限後に削除されること
- 外部送信が許可リスト内に限定されること
- 例外発生時に担当者へ通知されること
本記事ではこれらの実機検証を行っていないため、導入組織自身によるテストが必要です。
8. 変更監視と停止条件を決める
クラウドサービスの保持条件や対象モデルは変わります。月次またはモデル更新時にドキュメント、契約、管理画面を再確認し、差分を記録します。
ZDR適格性の変更、想定外の保持、第三者への送信、契約と実挙動の不一致が見つかった場合は、対象プロジェクトを停止し、機密度の低い代替処理へ切り替える条件を事前に決めておきます。
ZDRを導入判断へ使うチェックリスト
次の質問に一つでも答えられない場合、機密データを使った本番運用は保留するのが安全です。
- ZDRが必要なデータと業務を具体的に定義したか
- 自社の組織とプロジェクトが正式にZDR承認済みか
- 利用するモデル、API、ツールがZDR対象か
- 不正利用監視ログとapplication stateを区別したか
- 一時キャッシュやコンテナの保存条件を確認したか
- 自社アプリ、ゲートウェイ、監視製品のログを確認したか
- MCPなど第三者サービスの保持方針を確認したか
- 安全上・法令上の例外と通知方法を確認したか
- 個人情報の利用目的や必要最小限性を確認したか
- 保存されないことで失われる監査証拠を補う設計があるか
- 設定変更や仕様変更を定期的に再確認する責任者がいるか
- 問題発生時に送信を止められる仕組みがあるか
失敗しやすい5つの理解
「学習しないから保存もされない」
誤りです。モデル学習、不正利用監視、アプリケーション状態は別の目的です。APIデータが学習へ使われない標準方針だけで、保持期間を判断してはいけません。
「ZDRなら外部サービスにも残らない」
誤りです。MCPサーバー、検索、クラウドストレージ、社内ログには、それぞれ独立した保持条件があります。OpenAIのZDRは接続先の規約を上書きしません。
「暗号化されていれば保持期間は関係ない」
誤りです。暗号化は重要ですが、鍵の侵害、権限設定ミス、復号後の処理、バックアップ、削除漏れなどのリスクは残ります。鍵の管理者、ローテーション、失効、監査方法まで確認する必要があります。
「何も記録しないほど安全」
必ずしも正しくありません。事故調査、権限逸脱の検出、費用管理、異議申立てに必要な証拠まで消すと、別のリスクが生まれます。本文を残さず、操作事実を残す監査設計が必要です。
「プレビュー発表を正式な契約保証として使える」
危険です。Private Safety Processingは先行顧客とのテスト段階です。発表文は方向性を理解する材料ですが、自社に適用される契約条件や技術仕様の代わりにはなりません。
適用を急がない方がよい条件
次の状況では、Private Safety Processingの正式提供を待つか、匿名化したデータだけで限定運用する方が適切です。
- ZDRの対象モデルと機能を確認できない
- 法令や契約上、外部処理自体が認められていない
- 自社側のログやバックアップを制御できない
- 外部MCPサーバーの保持条件が不明である
- 安全シグナルの誤検知に対応する担当者がいない
- データを保存しないと法定記録や説明責任を果たせない
- 削除、暗号鍵、例外通知の条件を書面で確認できない
ZDRは、機密情報を無条件に入力してよい許可証ではありません。入力するデータを必要最小限にする、識別子を置き換える、権限を分ける、人による承認を挟むといった基本策は引き続き必要です。
今後見るべき3つのポイント
第一は技術白書です。OpenAIは発表時、Private Safety Processingの展開開始と技術白書の共有を9月に予定していると説明しました。白書では、暗号化したままどの範囲の分析を行うのか、脅威モデル、鍵管理、誤検知、障害時の処理がどこまで明らかになるかが焦点です。
第二は対象範囲です。フロンティアモデル、長時間タスク、ホスト型ツール、地域別処理の組み合わせによって保持条件が変わる可能性があります。モデル名だけでなく、実際に使うAPI機能を基準に確認する必要があります。
第三は安全監視の説明可能性です。元データをOpenAIの担当者が閲覧できない場合、顧客は限定された安全シグナルを基に利用制限の理由を理解しなければなりません。通知にどの程度の情報が含まれるか、正当な研究やセキュリティ業務が誤検知されたときにどう異議を申し立てるかは、実務上の重要な評価項目です。
まとめ
OpenAIのPrivate Safety Processingは、データを保持しなければ安全監視が弱くなり、安全監視を強めれば機密情報の保持が増えるという難題に対する一つの回答です。顧客管理の保存領域や暗号鍵と、自動的なパターン検出、限定された安全シグナルを組み合わせる方向性は、機密性の高い業務でフロンティアモデルを使うための選択肢を広げる可能性があります。
ただし、現時点ではプレビューであり、ZDRもシステム全体に及ぶ単純な「保存ゼロ」ではありません。導入判断では、学習利用、不正利用監視、application state、自社ログ、第三者送信、例外条件を分けて確認してください。
このニュースを実務へ反映する最初の一歩は、営業担当へ「ZDRに対応していますか」と尋ねることではありません。自社システムのデータフローを描き、どの経路で何がどれだけ残るかを一覧にすることです。その表があって初めて、ZDRやPrivate Safety Processingが自社の要件を本当に満たすかを判断できます。
確認日:2026年8月22日。主要な一次情報として、OpenAIのPrivate Safety Processing発表、APIデータ管理ドキュメント、モデル学習に関する方針、個人情報保護委員会の注意喚起、NISTの生成AIリスク管理プロファイルを確認しました。
PRIMARY SOURCES
確認した一次情報
- Offering Zero Data Retention for frontier modelsOpenAI · 2026年8月22日
- Data controls in the OpenAI platformOpenAI · 2026年8月22日
- How your data is used to improve model performanceOpenAI · 2026年8月22日
- 生成AIサービスの利用に関する注意喚起等について個人情報保護委員会 · 2026年8月22日
- Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence ProfileNational Institute of Standards and Technology · 2026年8月22日
広告